WEB問題集
ある法律事務所が Amazon Bedrock を用いて、数百ページに及ぶ訴訟資料を読み込み、複雑な法的論点を多段階で推論しながら高品質な要約と論点整理を行うアシスタントを構築しています。出力の正確性と推論の深さが最優先であり、応答レイテンシやトークンあたりのコストは二次的な制約です。チームはまず単一の Amazon Bedrock 基盤モデルでパイロットを開始したいと考えています。最も適切な基盤モデルはどれですか。
解説
【正解: A】の理由
決め手は「出力の正確性と推論の深さが最優先で、レイテンシとコストは二次的」という条件です。Claude 3 ファミリーは Haiku、Sonnet、Opus の順に能力が上がり、Opus は最も高い推論能力と品質を持つため、数百ページの訴訟資料から多段階で法的論点を推論する用途に合います。単価や応答速度の不利は本問では二次的な制約なので、選定を妨げません。
【他選択肢が違う理由】
- C: Claude 3 Haiku は最速・最安ですが推論品質は Opus に劣り、品質最優先の要件に合いません。
- B: Titan Text Lite は軽量・低コスト用途向けで、多段階推論を要する法的分析には能力が不足します。
- D: Stability AI のモデルは画像生成用であり、テキストの法的論点を推論・要約するタスクには使えません。
【参考】
解説
【正解: C / A】の理由
RAG (Knowledge Bases for Amazon Bedrock) を採用すれば、文書更新は同期だけで反映でき再学習が不要なため、小規模チームでも運用できます (C)。さらに RetrieveAndGenerate のシテーションを使えば、回答の各部分の根拠となった文書・箇所を出典として明示でき、監査要件も満たせます (A)。
【他選択肢が違う理由】
- E: 毎月のファインチューニングは再学習コストが高く、小規模チームの運用負荷と出典提示の要件に反します。
- D: プロンプトへの固定埋め込みはコンテキスト上限を超え、更新のたびに改修が必要で運用に適しません。
- B: ランダム検索は関連性を担保できず、回答品質が破綻します。
【参考】
Amazon Bedrock コンソールでナレッジベースを作成する手順を正しい順序に並べ替えてください。
- ナレッジベースを作成しデータソースの同期を実行する
- 埋め込みモデルとベクトルストアを構成する
- データソース (Amazon S3 など) と取り込み対象を指定する
- ナレッジベースに付与する IAM サービスロールを指定する
解説
【正しい順序】
- ナレッジベースに付与する IAM サービスロールを指定する
- データソース (Amazon S3 など) と取り込み対象を指定する
- 埋め込みモデルとベクトルストアを構成する
- ナレッジベースを作成しデータソースの同期を実行する
【ポイント】
- ステップ 1 サービスロール指定: ナレッジベースがデータソースやモデルへアクセスするための IAM サービスロールを指定します。
- ステップ 2 データソース指定: 取り込み対象となる S3 などのデータソースを指定します。
- ステップ 3 埋め込み/ベクトルストア構成: 埋め込みモデルと、ベクトルを格納するベクトルストアを構成します。
- ステップ 4 作成と同期: ナレッジベースを作成し、データソースの同期 (ingestion) を実行します。
誤った順序の問題点:
- データソースを指定せずに同期を実行する: 取り込むデータソースが未指定だと、同期で処理する対象がありません。
- 埋め込みモデルを構成せずベクトルストアを使う: 埋め込みモデルがないとチャンクをベクトル化できず、ベクトルストアに格納できません。
【参考】
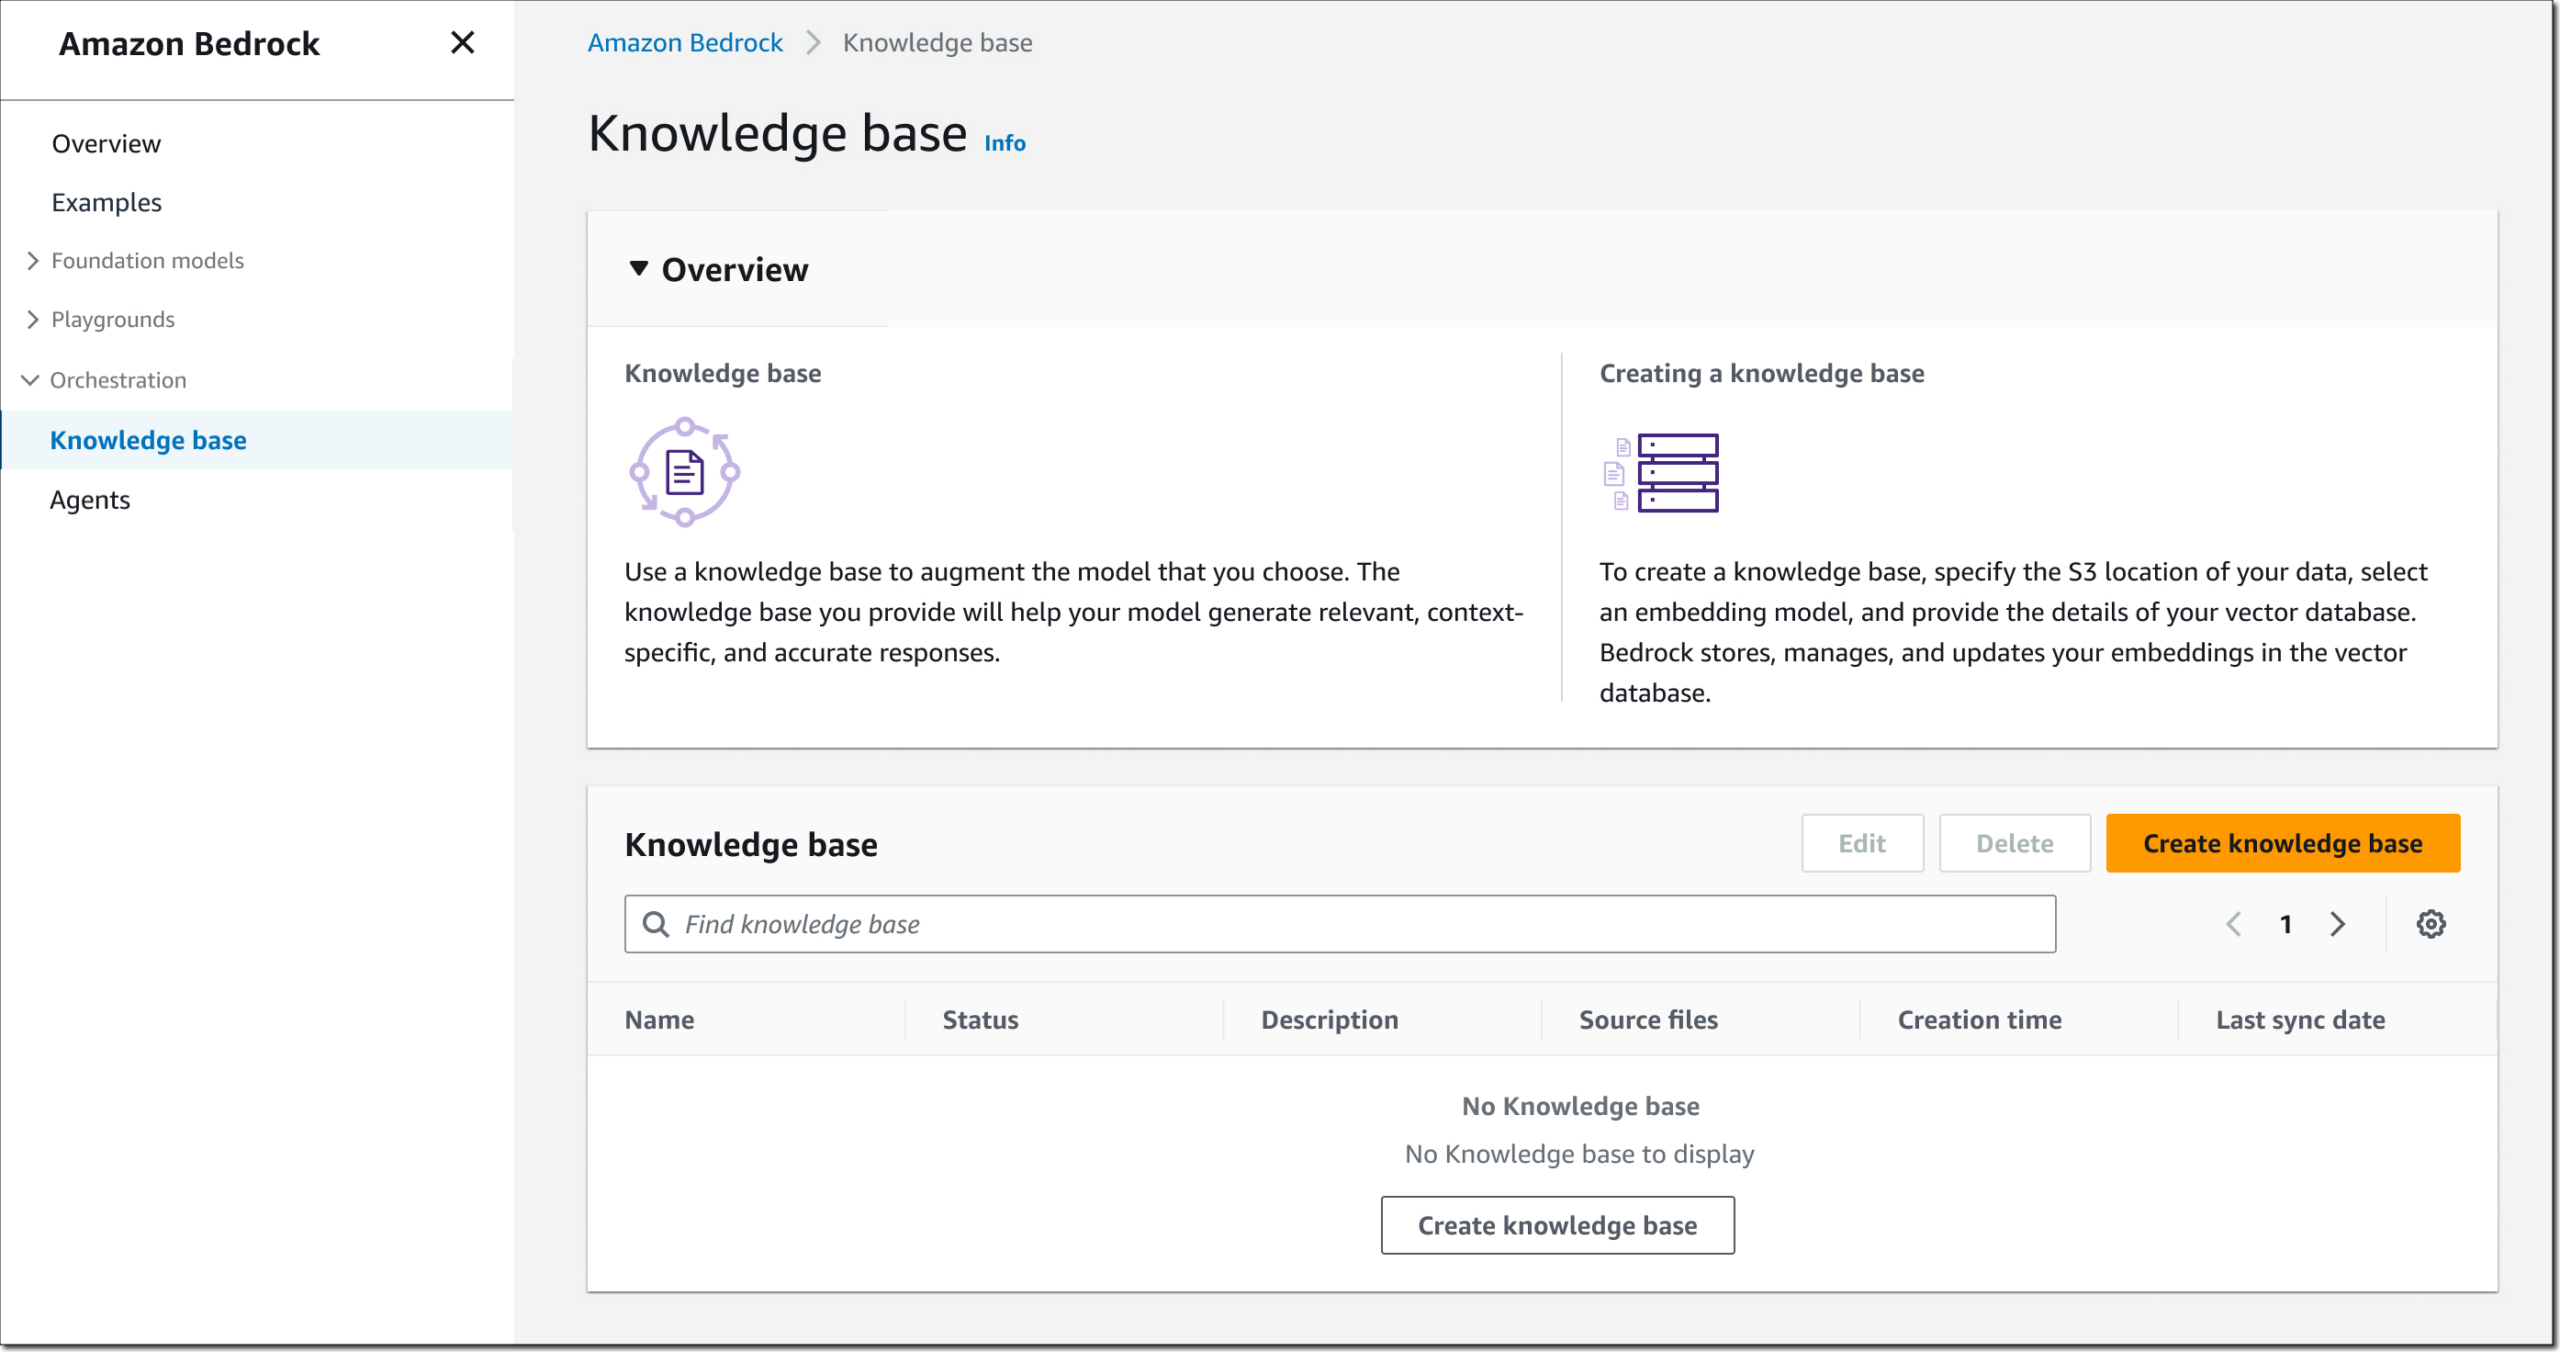
図は Amazon Bedrock を中心とした生成 AI アプリケーションの全体構成を示しています。ある開発チームが、複数の基盤モデルプロバイダー (Anthropic Claude、Amazon Nova、Meta Llama など) を切り替えながら、統一されたメッセージ形式とマルチターン会話を扱える単一の API でチャットアプリを構築したいと考えています。プロバイダーごとのリクエスト形式の差異を吸収できる、最も適切な Amazon Bedrock の API はどれですか。
解説
【正解: C】の理由
決め手は「複数プロバイダーを切り替える」「統一されたメッセージ形式」「マルチターン会話」の 3 条件です。Converse API はメッセージに対応するモデルで共通のリクエスト形式を使い、プロバイダーごとの body の違いを吸収するため、同じコードでモデル ID だけを替えて呼び出せます。会話履歴も messages 配列として同じ形式で渡せるので、マルチターンのチャットにそのまま使えます。
【他選択肢が違う理由】
- A: InvokeModel はモデルごとに body の形式が異なり、統一 API の要件を満たせず保守負荷も高くなります。
- D: バッチ推論はオフライン大量処理向けであり、対話型のマルチターン会話には適しません。
- B: CreateModelCustomizationJob はモデルのファインチューニングを開始する API で、会話には使いません。
【参考】
ベクトル検索で用いる代表的な距離(類似度)指標を比較します。
| 指標 | 特徴 | 典型的な用途 |
|---|---|---|
| コサイン類似度 | 向き(角度)で評価、大きさの影響を受けにくい | テキスト埋め込みの意味的類似 |
| ユークリッド距離 | 点間の直線距離 | 大きさ・絶対位置が重要な場合 |
| 内積(dot product) | 正規化済みならコサインと等価 | 正規化済みベクトルでの高速類似度 |
ベクトルの大きさの影響を受けずに、文書の意味的な向きの近さで類似度を測りたい場合に最も一般的に推奨される指標はどれですか。
解説
【正解: B】の理由
決め手は「ベクトルの大きさの影響を受けずに、意味的な向きの近さで測りたい」という条件で、表の「特徴」の列がそのまま判断材料になります。コサイン類似度は向き (角度) で評価し大きさの影響を受けにくいため、テキスト埋め込みの意味的類似に最も一般的に使われます。内積も正規化済みならコサインと等価ですが、選択肢は非正規化の内積なので大きさの影響を受けます。
【他選択肢が違う理由】
- A: ユークリッド距離はベクトルの大きさ・絶対位置の影響を受けるため、意味的類似の標準指標としてはコサインより一般的ではありません。
- D: 非正規化の内積は大きさの影響を受けるため、向きのみで測りたい要件には適しません。
- C: ハミング距離はビット列向けで、連続値の埋め込みには適しません。